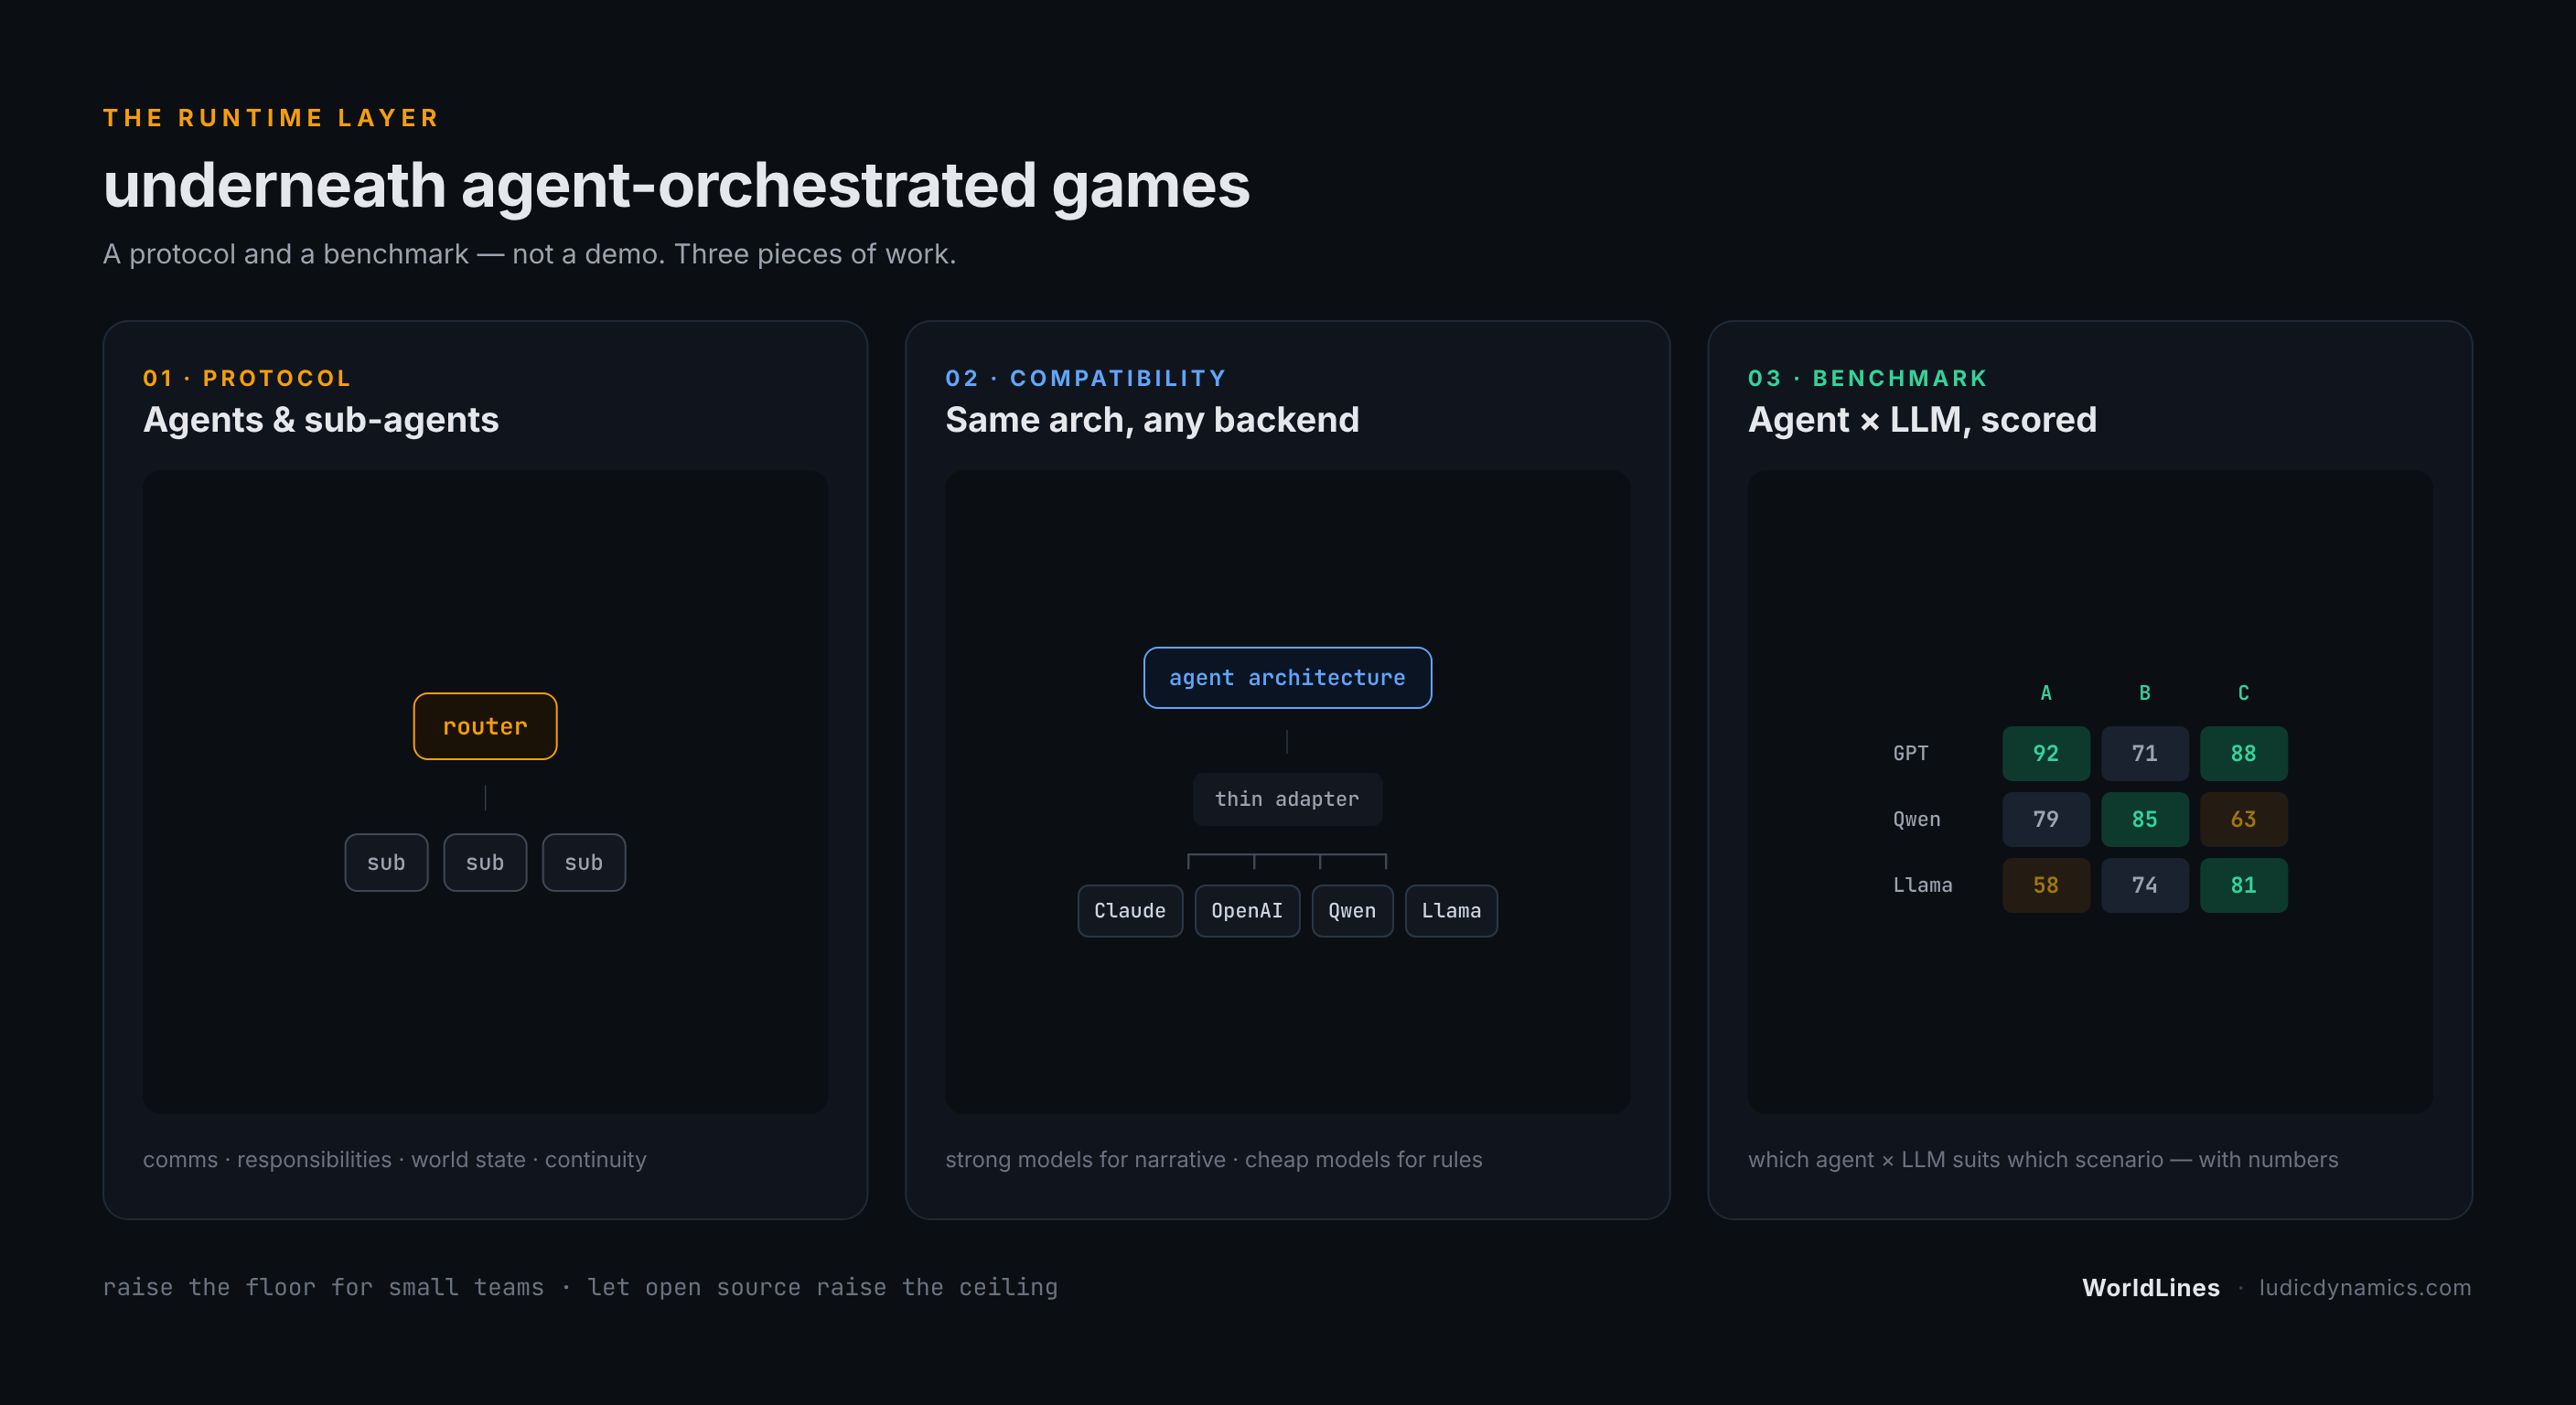
우리는 Claude Code 스타일의 agentic 오케스트레이션을 게임에 쓰기 위한 프로토콜과 벤치마크를 만들고 있습니다 — 시뮬레이션, 롤플레잉, 내러티브, 월드 모델 기반 경험까지.
핵심은 또 하나의 AI TRPG 데모를 내는 게 아니라, 그런 게임들 아래에 깔리는 런타임 계층입니다: 세계, 캐릭터, 기억, 규칙, 내러티브를 역할이 나뉜 agent 들이 함께 조율하는 시스템. 그리고 그 조율 자체를, 지난 20 년의 게임 엔진처럼 검사하고, 교체하고, 벤치마크할 수 있게.
일은 세 갈래.
agent 와 sub-agent 를 위한 프로토콜
영감은 Claude Code 의 router → sub-agent 스타일. 그것을 게임 세계용으로 맞춥니다. 프로토콜이 정의할 것:
-
agent 간 통신 방식 — 메시지 형태, 도구 노출 표면, 상태 인계
-
책임 분담 — 누가 무엇을 읽고, 누가 무엇을 쓰는가
-
세계 상태 갱신 — 파일인가, 구조화 이벤트 로그인가
-
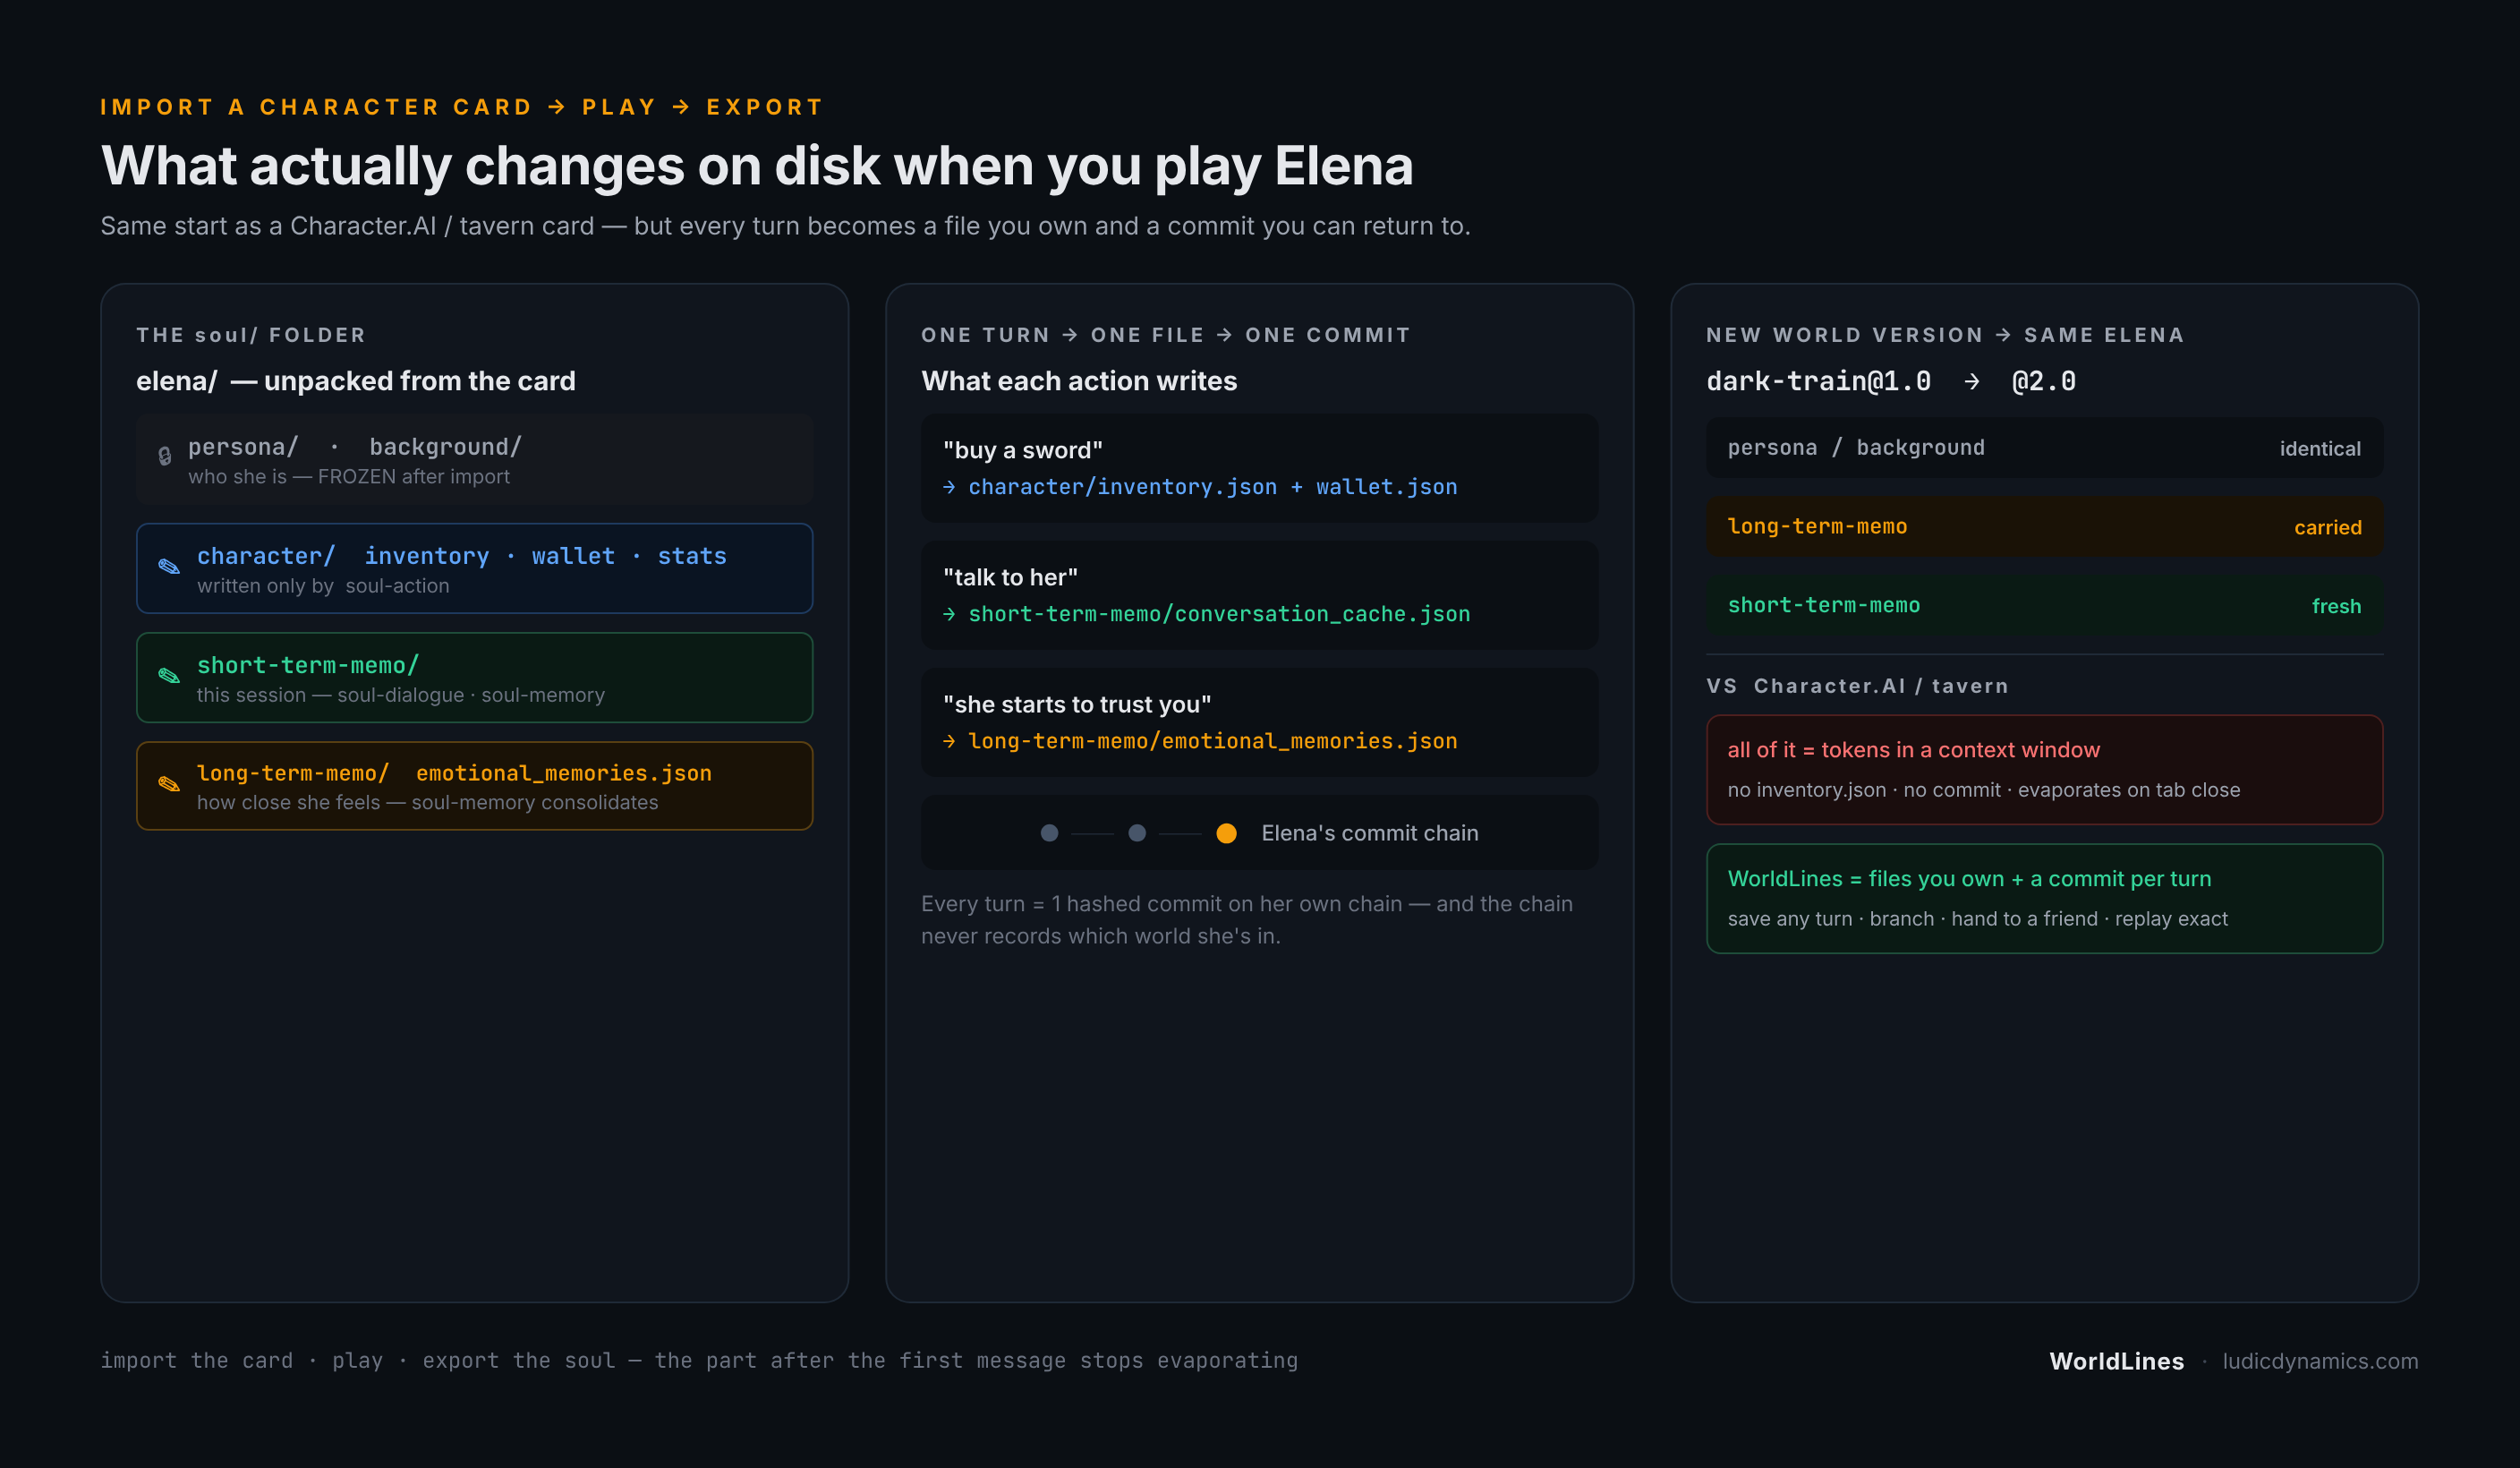
캐릭터의 일관성 유지 — 캐릭터별 메모리 구조
-
자유도와 내러티브 일관성의 균형
지금 이것들은 WorldLines 저장소의 「관습」 형태로 존재합니다. 다른 팀이 읽고, 구현하고, 반박할 수 있는 프로토콜로 끌어올리는 것 — 이 블록의 일입니다.
더 많은 agent 시스템과 저비용 LLM 호환
「Claude 전용 클럽」은 만들고 싶지 않습니다. 풍부한 롤플레이 한 턴은 agent 호출을 수십 개 조합합니다. 그 모든 호출이 최첨단 유료 모델을 요구한다면, 몇몇 스튜디오를 제외한 모두에게 경제성이 맞지 않습니다.
구체적으로:
-
얇은 런타임 어댑터 (Claude Code, OpenAI 호환 API, 로컬 Qwen / Llama 계열, 미래의 agent SDK)
-
agent 단위 모델 선택 — 내러티브엔 강한 모델, 규칙 판정엔 저렴한 모델
-
단일 가격대가 아닌, 계속 밀어 올릴 수 있는 「품질/비용」 프런티어
같은 아키텍처, 다른 백엔드, 시간이 갈수록 낮아지는 세션당 비용.
agent × LLM 조합을 위한 벤치마크
공개된 LLM 벤치마크는 롤플레이가 진짜 신경 쓰는 능력을 간접적으로만 측정합니다 — 회상, 수학, 코드, 지시 따르기. 어떤 모델이 NPC 를 40 세션 동안 일관되게 유지할 수 있는지, 어떤 agent-LLM 조합이 감정 장면을 일반적 격려 문장으로 무너뜨리지 않는지 — 알려주지 않습니다.
우리는 agent 오케스트레이션 시스템 과 언어 모델 을 함께 평가하는 벤치마크를 만듭니다. 결과는 조합 단위로 발표: 「모델 X 를 agent 시스템 A 에서 돌리면 Y 점; 같은 모델을 B 에서 돌리면 Z 점」. 평가 차원:
-
세션을 가로지르는 캐릭터 일관성
-
장기 메모리 검색
-
플레이어 부재 시의 세계 시뮬레이션
-
감정 인터랙션
-
arc 길이의 내러티브 통제
-
멀티 캐릭터 조율
결과물: 어떤 agent-LLM 구성이 어떤 롤플레이 시나리오에 가장 맞는지, 숫자로 뒷받침된 한 장의 지도.
이 일이 최종적으로 향하는 곳
AI-native 게임은 고립된 챗봇 대화가 아니라, 살아 있는 세계처럼 느껴져야 합니다 — 연속적이고, 스스로의 움직임을 가지며, 플레이어가 무엇을 했는지 기억하는 세계. 프로토콜, 호환 계층, 벤치마크 — 모두 같은 목표를 향합니다: 작은 팀이 닿는 바닥을 끌어올리고, 천장은 OSS 생태계가 계속 밀어 올릴 수 있게.
각 조각이 자리 잡는 대로, 더 이야기하겠습니다.