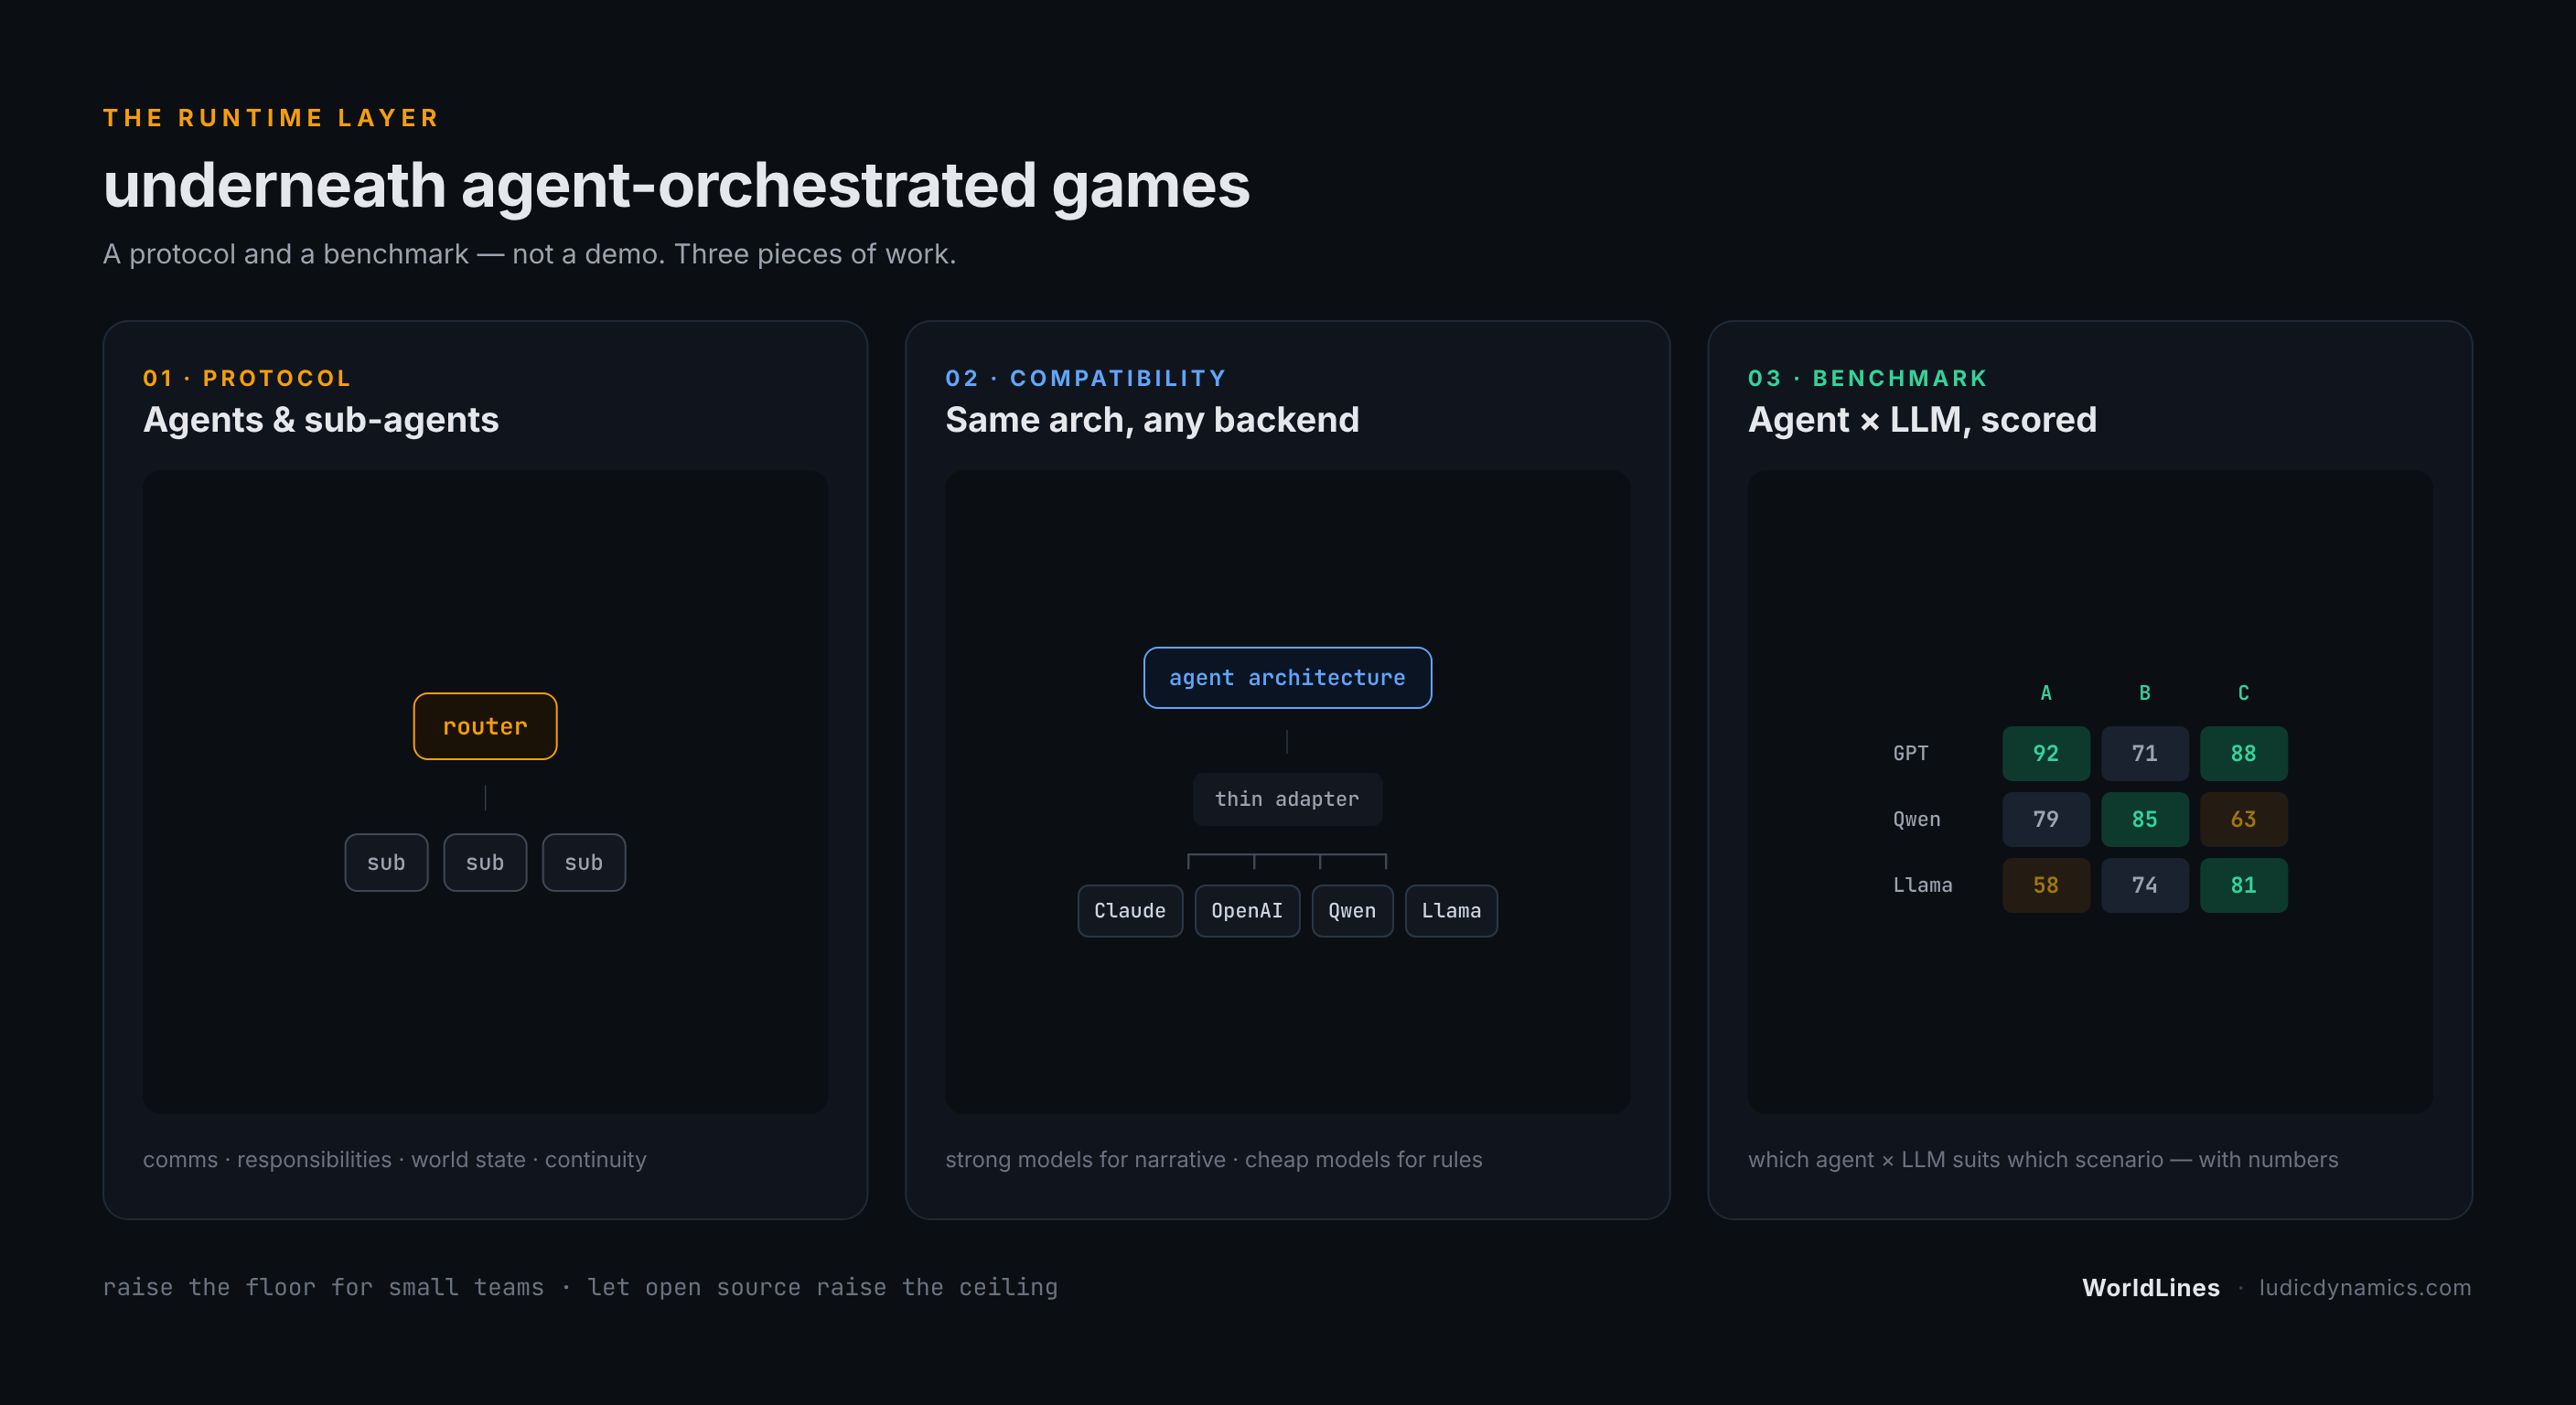
Claude Code 流の agentic 編成をゲームに使うためのプロトコルとベンチマークを作っています —— シミュレーション、ロールプレイング、ナラティブ、world-model 駆動の体験を対象に。
ポイントは AI TRPG のデモを 1 本出すことではなく、その下にあるランタイム層です:世界・キャラ・記憶・ルール・物語を、役割の分かれた agent が一緒に動かす。そしてその連携自体を、過去 20 年のゲームエンジンと同じく、検査でき、差し替えられ、ベンチマークできる。
仕事は 3 つ。
agent と sub-agent のプロトコル
発想元は Claude Code の router → sub-agent スタイル。それをゲーム世界向けに調整します。プロトコルが定義するもの:
-
agent 間の通信方法 —— メッセージ形状、ツールサーフェス、状態の引き渡し
-
責任分担 —— 誰が何を読むか、誰が何を書くか
-
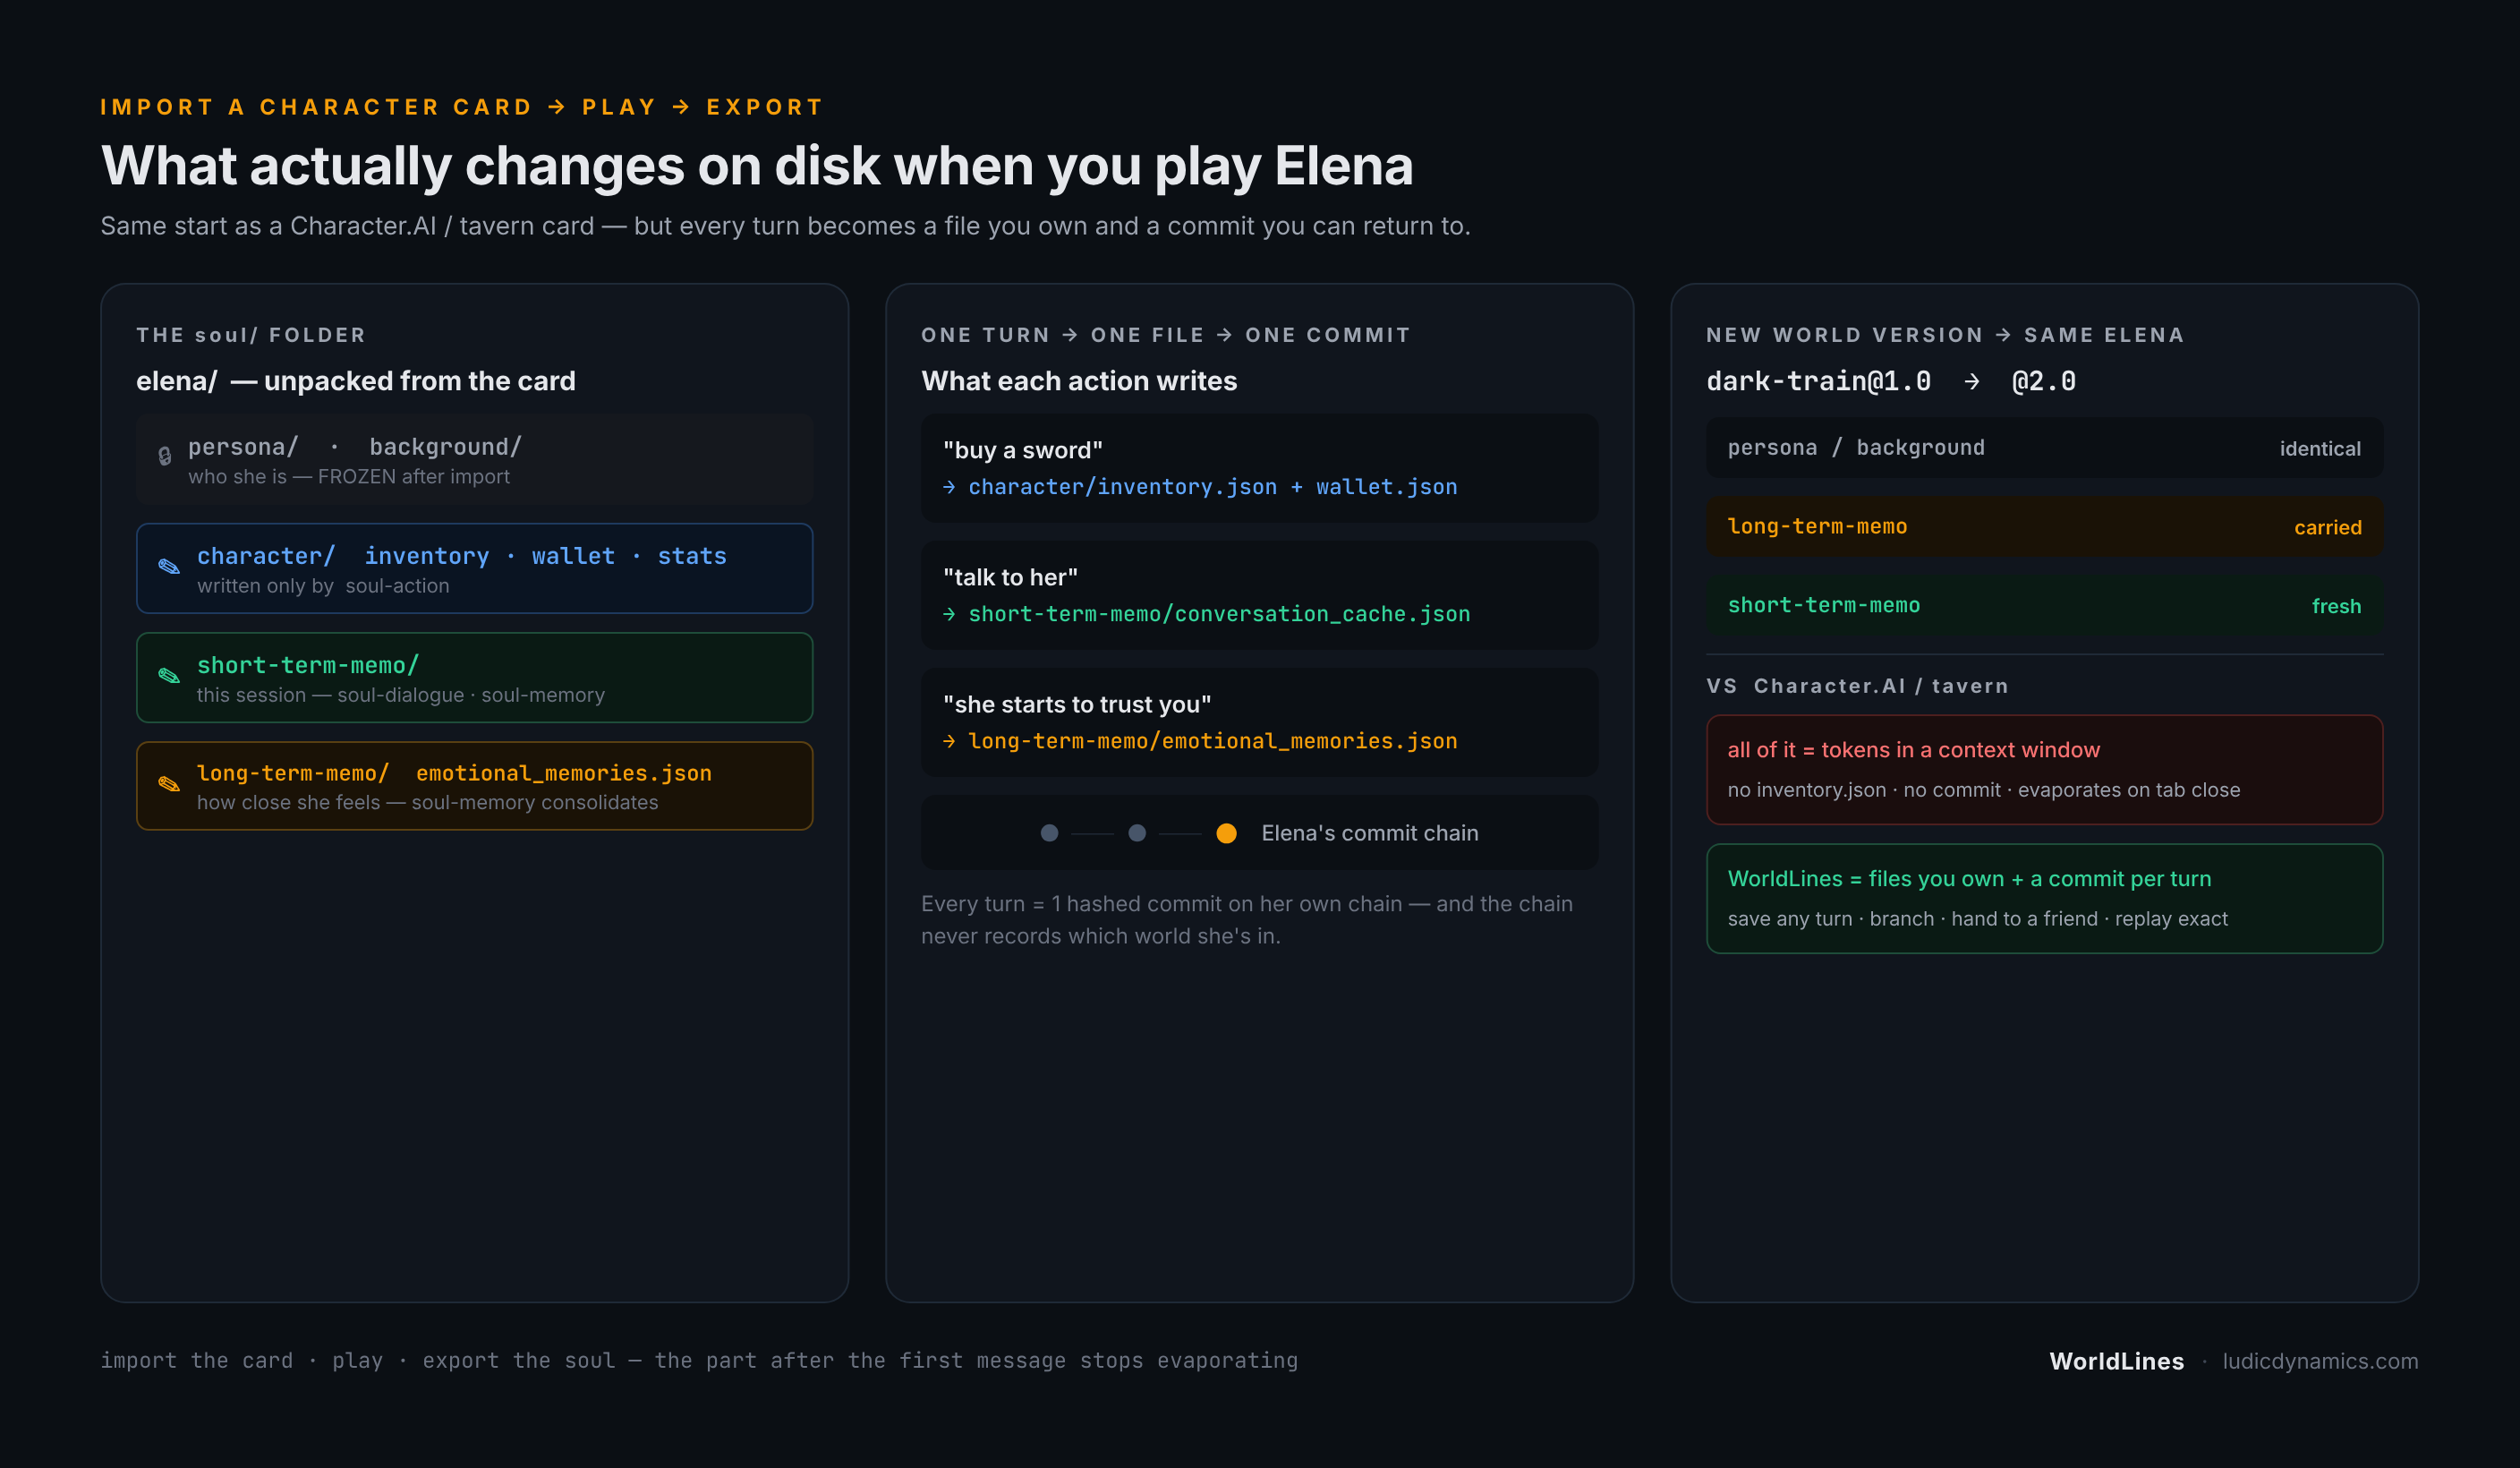
世界状態の更新方法 —— ファイル、それとも構造化イベントログ
-
キャラクターの一貫性の保ち方 —— キャラごとの記憶レイアウト
-
自由度とナラティブの一貫性のバランス
今これらは WorldLines リポジトリ内の「慣習」として存在しています。これを、他のチームが読み、実装し、異論を出せる「プロトコル」へ引き上げる、というのがここの仕事。
より多くの agent システムと、低コスト LLM への対応
「Claude 専用クラブ」にはしたくない。豊かなロールプレイの 1 ターンは agent 呼び出しを何十回も組み合わせます。そのすべてに最先端の有料モデルを要求したら、一握りのスタジオ以外、経済性が合いません。
具体的には:
-
薄いランタイムアダプタ(Claude Code、OpenAI 互換 API、ローカル Qwen / Llama 系、将来の agent SDK)
-
agent ごとのモデル選択 —— ナレーションは強いモデル、ルール判定は安いモデル
-
単一の価格帯ではなく、押し広げていける「品質/コスト」のフロンティア
同じアーキテクチャ、違うバックエンド、セッション単価を時間とともに下げていく。
agent × LLM の組み合わせのためのベンチマーク
公開されている LLM ベンチマークは、ロールプレイが本当に気にする能力を間接的にしか測れません —— 想起、数学、コード、指示追従。NPC を 40 セッション越しに一貫させられるか、ある agent-LLM の組み合わせが感情シーンを汎用の励まし文へ崩さずに扱えるか、教えてはくれません。
私たちは agent 編成システム と 言語モデル を一緒に評価するベンチマークを作っています。結果は組み合わせ単位で出す:「モデル X を agent システム A で動かすと Y 点;同じモデルを B で動かすと Z 点」。評価する次元:
-
セッションをまたいだキャラクターの一貫性
-
長期記憶の検索
-
プレイヤー不在時の世界シミュレーション
-
感情インタラクション
-
arc 単位のナラティブ制御
-
マルチキャラの協調
アウトプットは 1 枚の地図:どの agent-LLM 構成がどのロールプレイシーンに向くか、数字で裏付けられたもの。
最終的にどこへ向かうか
AI-native のゲームは、孤立したチャットボット会話ではなく、生きている世界に感じられるべきだ —— 連続的で、自らの動きを持ち、プレイヤーが何をしたかを覚えている。プロトコル、互換層、ベンチマーク、すべて同じ目標のため:小規模チームが届く下限を底上げし、上限は OSS エコシステムが押し上げ続けられるようにする。
それぞれが形になり次第、もっと話します。