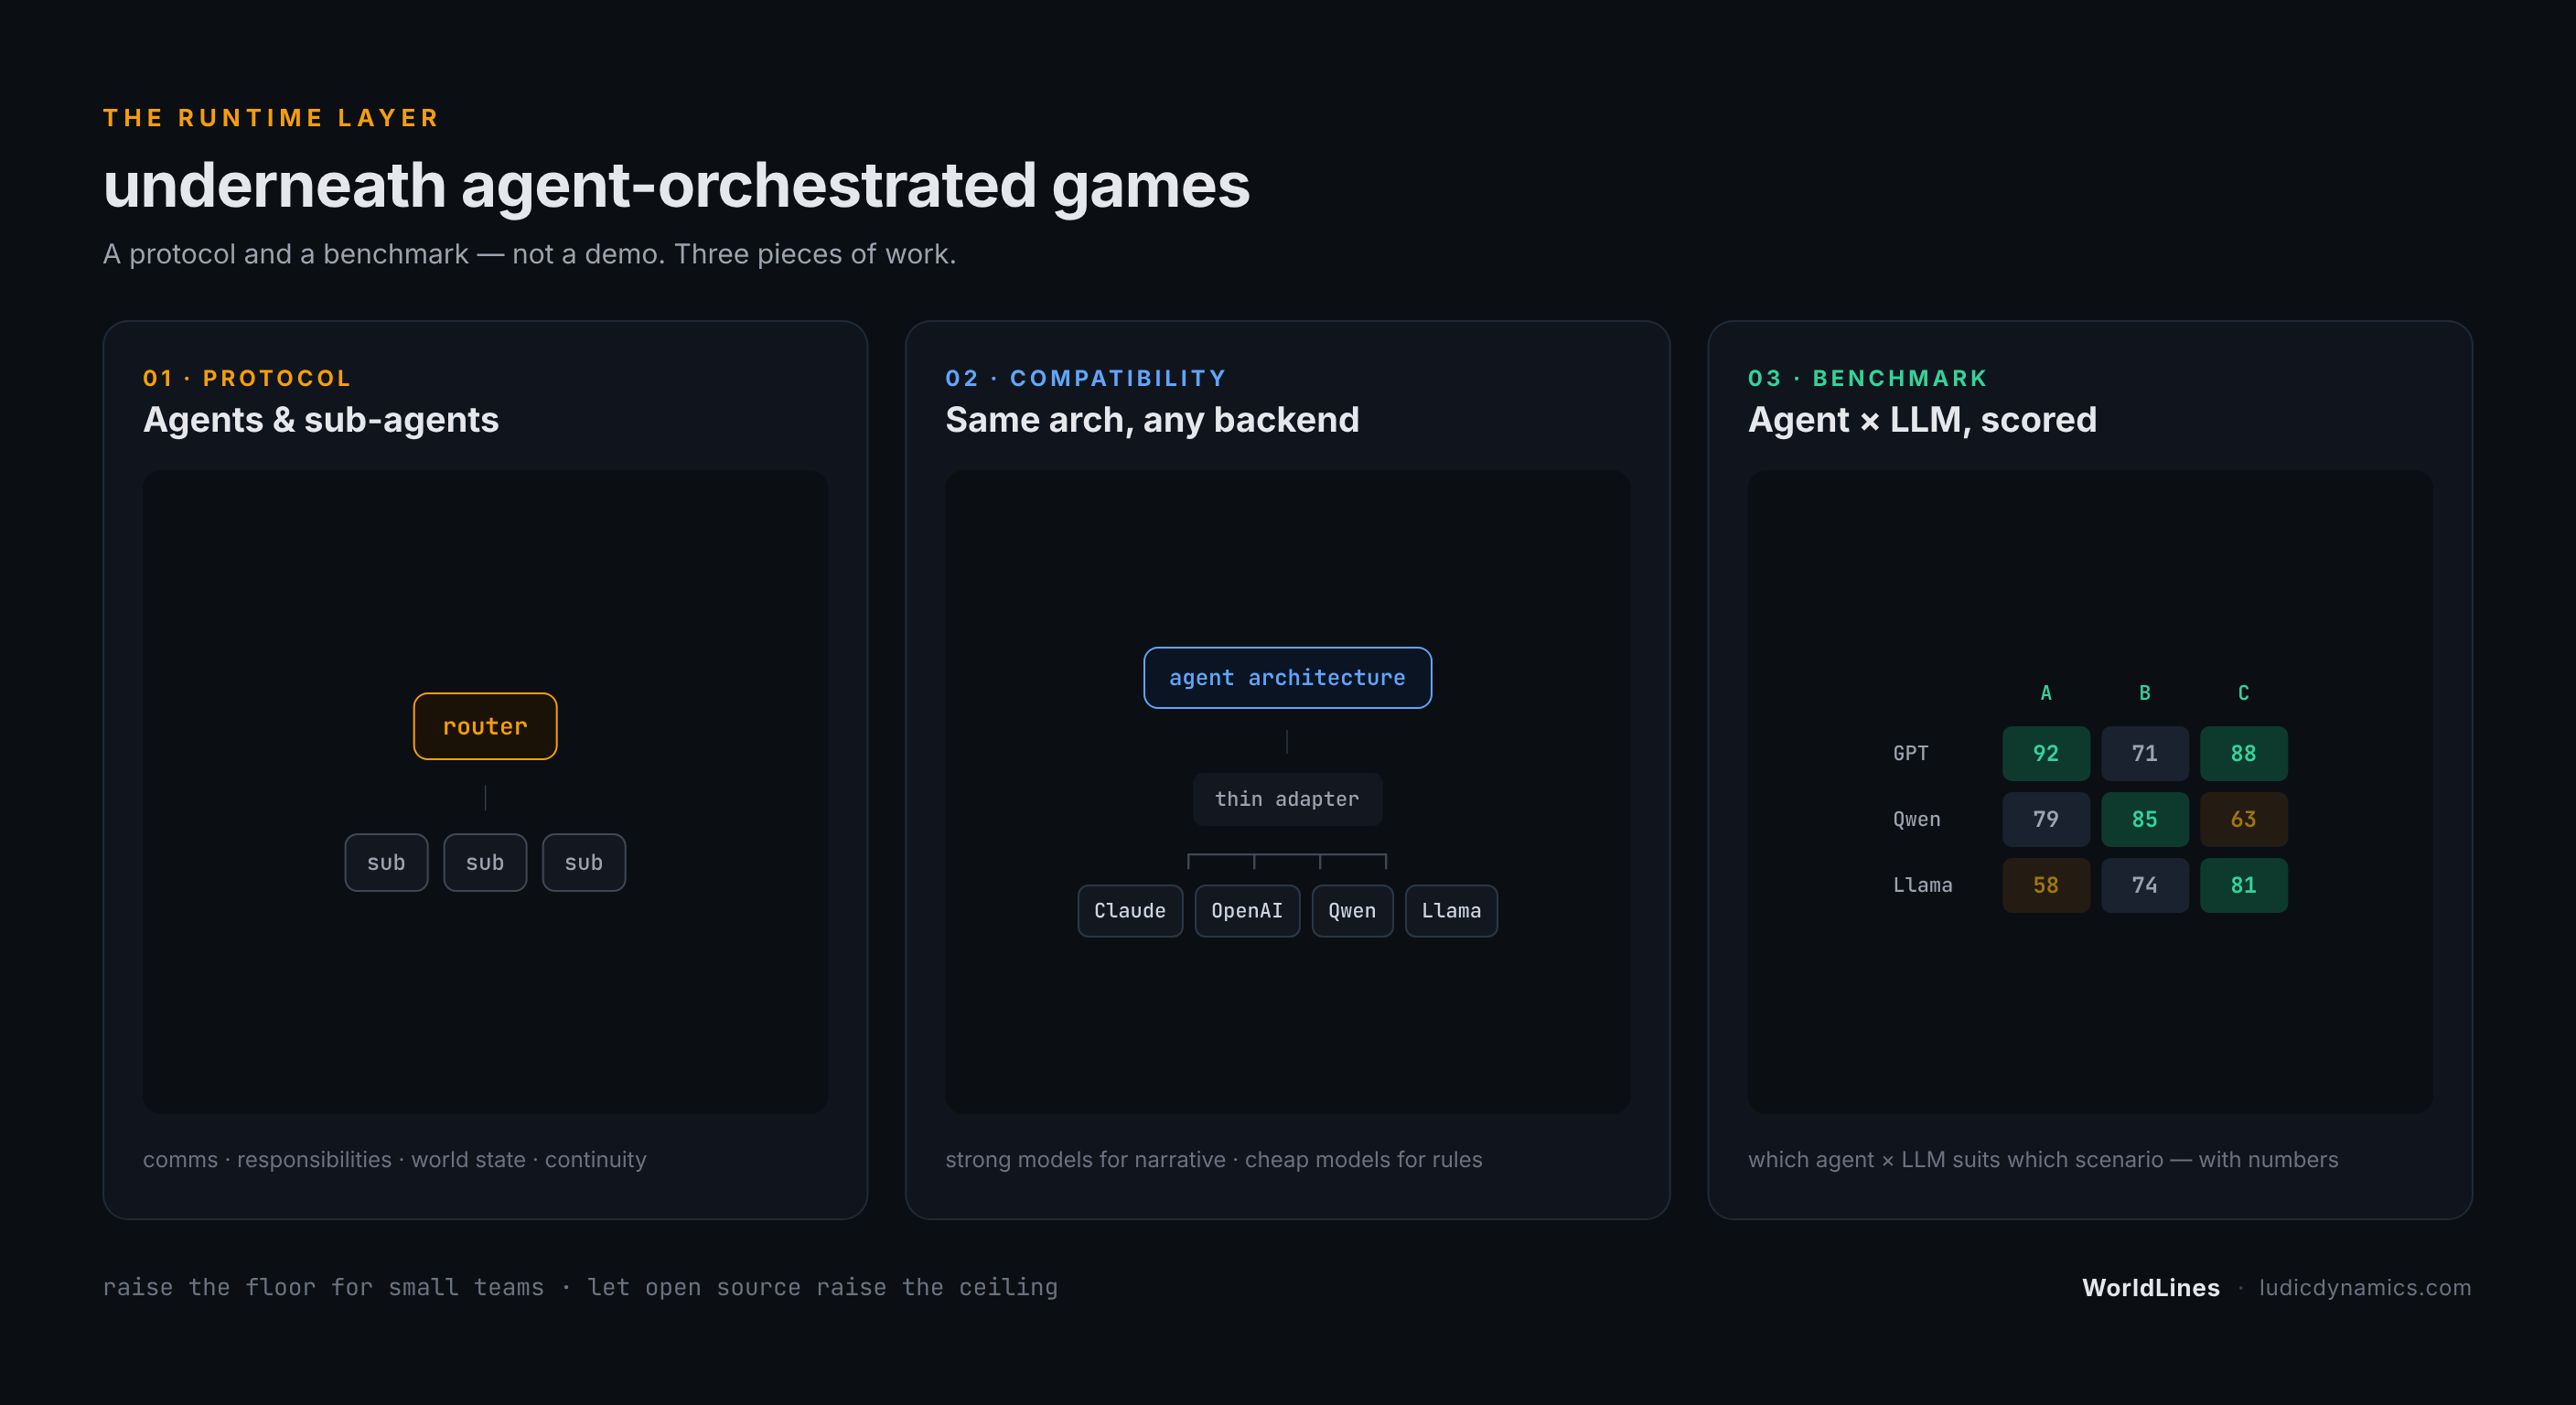
我们正在做一套协议、一套 benchmark,让 Claude Code 风格的 agent 编排能用于游戏 —— 模拟、角色扮演、叙事、世界模型驱动的体验。
重点不在再做一个 AI TRPG demo,而在这些游戏底下的运行时层:世界、角色、记忆、规则、叙事,由分工明确的 agent 一起协调;这种协调能像过去 20 年的游戏引擎那样被检视、被替换、被 benchmark。
三块工作。
agent 与 sub-agent 的协议
灵感来自 Claude Code 的 router → sub-agent 风格,适配的是游戏世界。协议要定义:
-
agent 之间如何通信 —— 消息形状、工具暴露面、状态交接
-
责任如何划分 —— 谁读什么、谁写什么
-
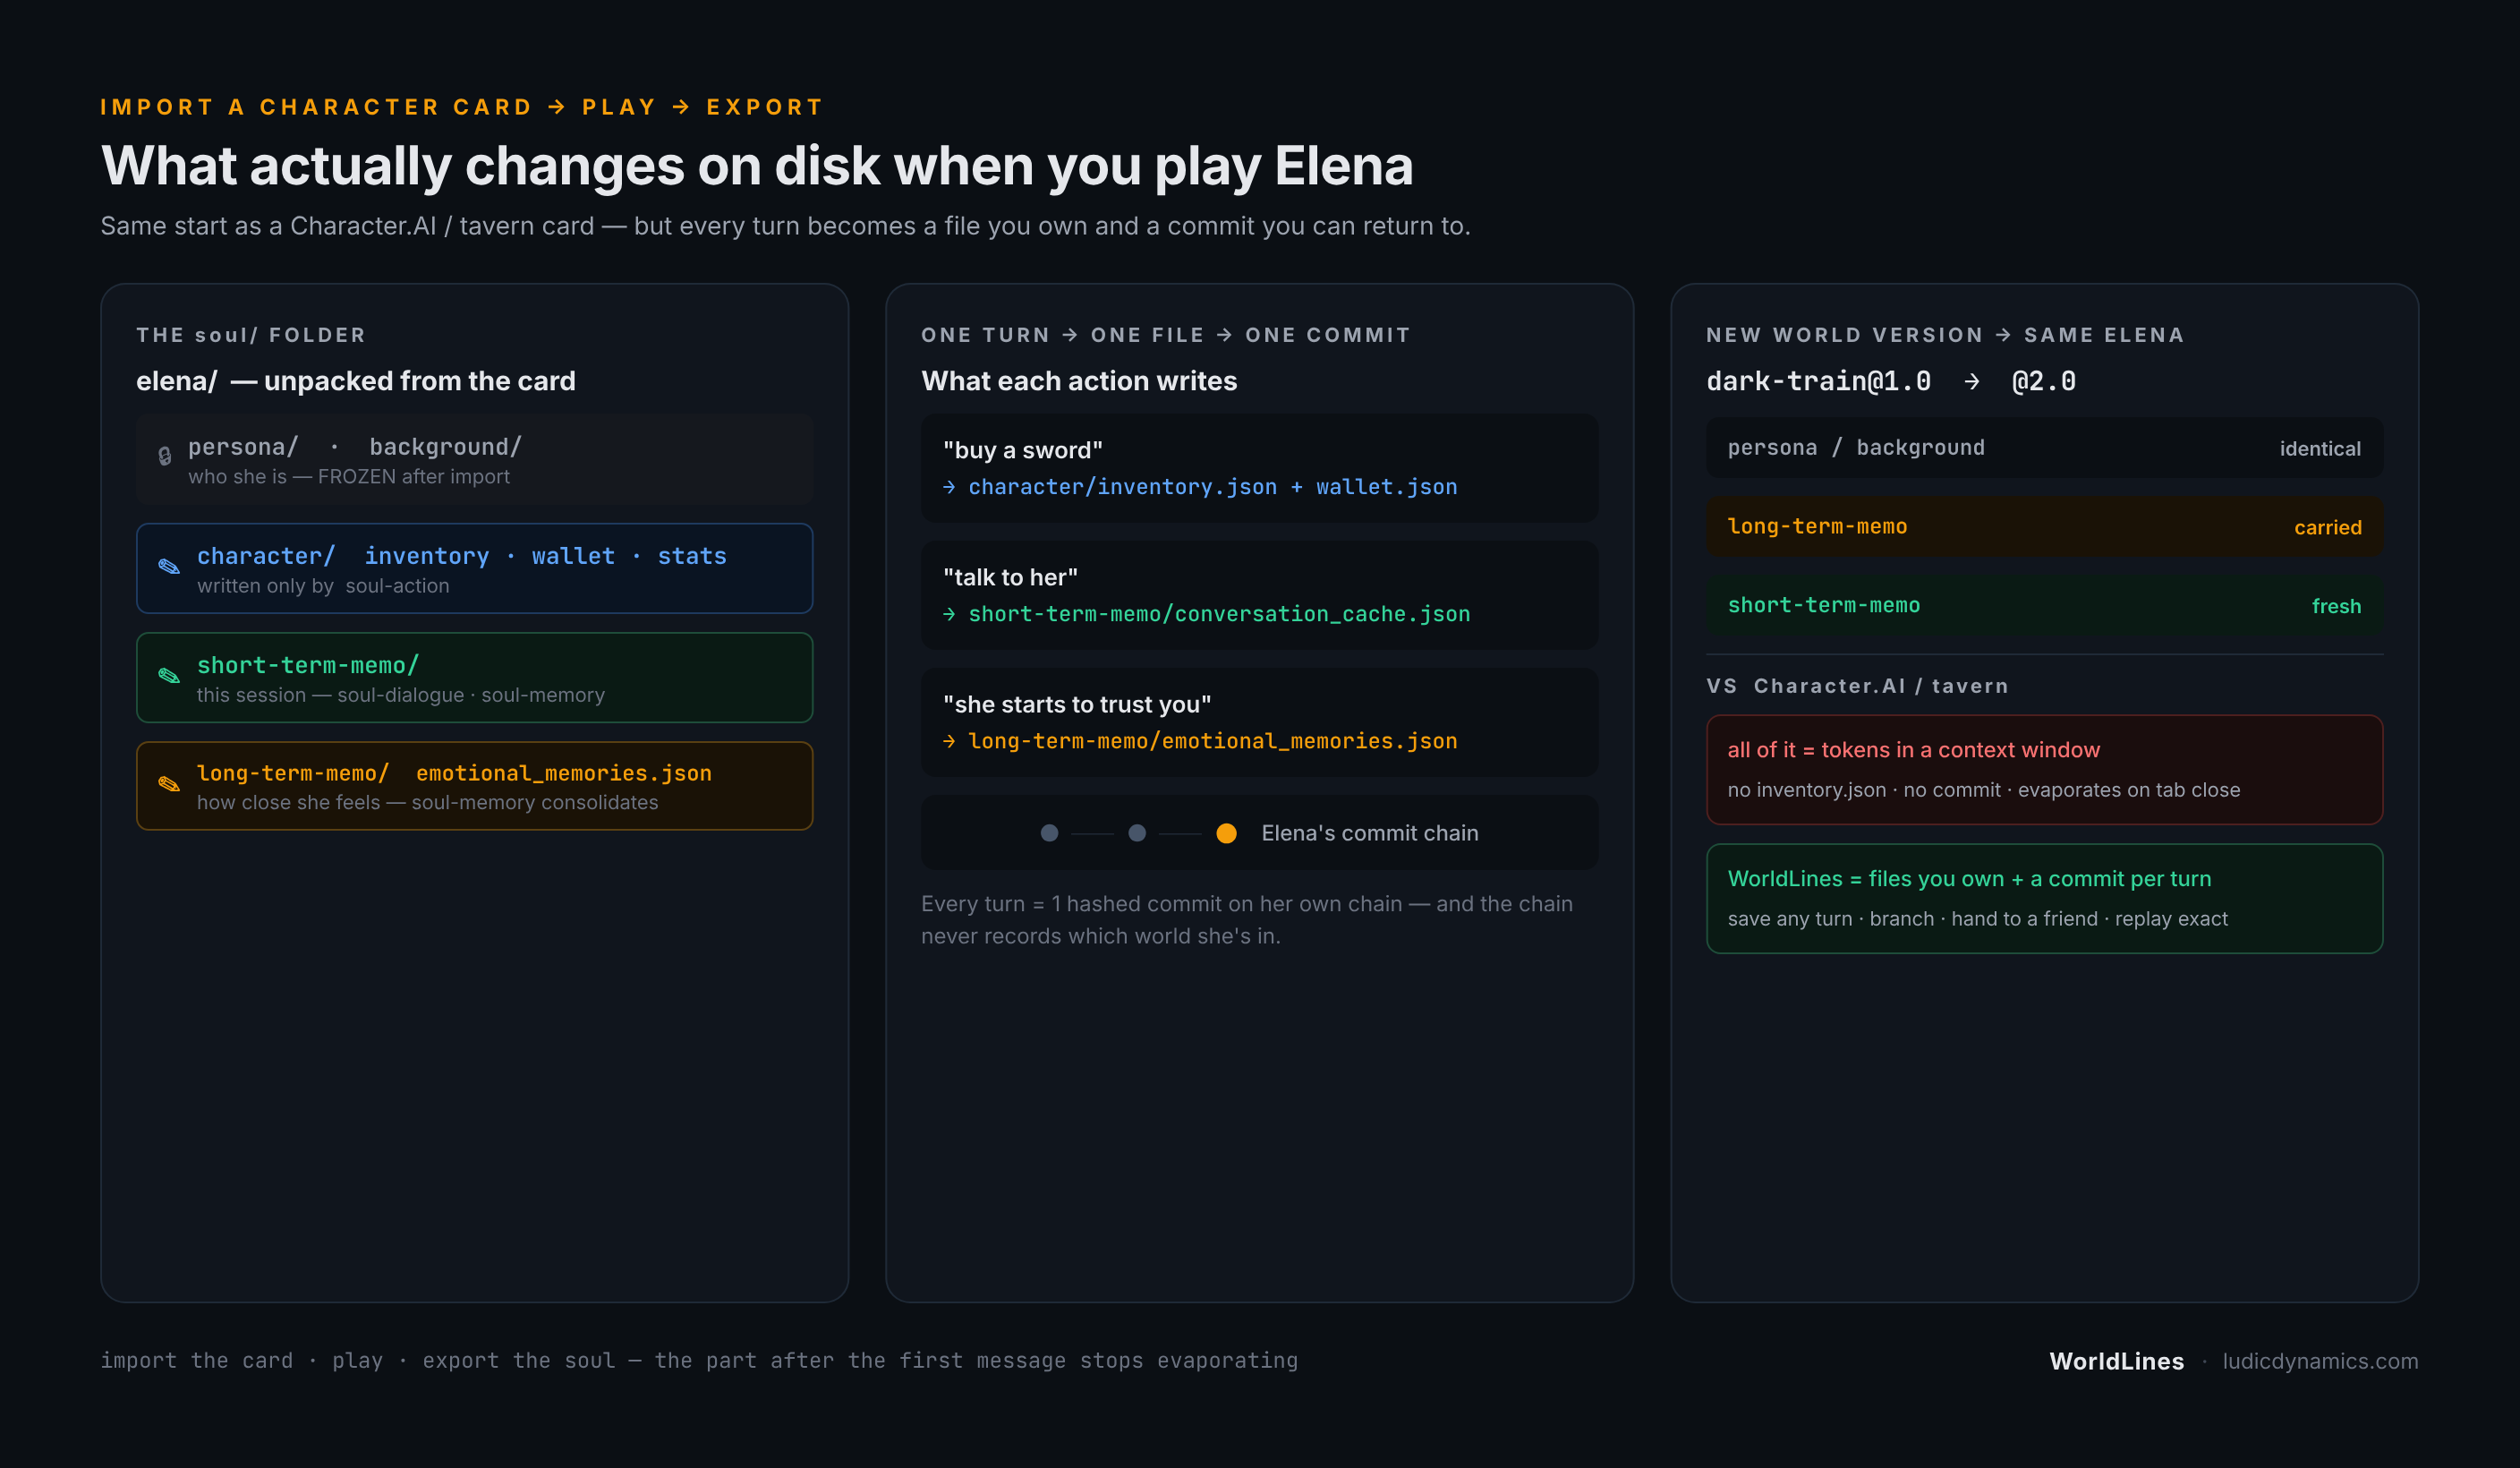
世界状态如何更新 —— 文件,还是结构化事件日志
-
角色如何保持一致性 —— 每个角色的记忆布局
-
自由度与叙事一致性如何平衡
今天这些以「约定」的形式存在 WorldLines 仓库里。要做的,是把它们抬升成别人能读、能实现、能反对的协议。
兼容更多 agent 系统与低成本 LLM
不想做「只能跑 Claude」的俱乐部。一回合丰富的角色扮演要组合几十个 agent 调用;如果每一次都得用最前沿的专有模型,账只对少数几家工作室算得过来。
具体来说:
-
一层薄的 runtime 适配(Claude Code、OpenAI 兼容 API、本地 Qwen / Llama 系、未来的 agent SDK)
-
按 agent 选模型 —— 叙事用强模型,规则判定用便宜模型
-
一条可以不断推进的「质量/成本」前沿,而不是单一价位
同一套架构、不同后端、每场游戏成本随时间往下走。
agent × LLM 组合的 benchmark
公开 LLM benchmark 衡量角色扮演关心的能力只能间接——回忆、数学、代码、指令跟随。没有哪个告诉你:这个模型能不能让一个 NPC 在 40 场之后还保持一致,某一组 agent-LLM 处理情感戏会不会塌成「鼓励语」。
我们做的 benchmark 同时评估 agent 编排系统 与 语言模型。结果按组合发布:「模型 X 在 agent 系统 A 下得 Y 分;同一个模型在 B 下得 Z 分」。要测的维度:
-
跨场次的角色一致性
-
长期记忆检索
-
玩家不在场时的世界仿真
-
情感互动
-
一个 arc 跨度的叙事控制
-
多角色协调
产出:一张地图 —— 哪些 agent-LLM 组合最适合哪些角色扮演场景,背后有数字。
这件事最终的方向
AI-native 的游戏应该不像一段孤立的聊天对话,而更像一个真实的世界 —— 持续、有自己的意志、记得玩家做过什么。协议、兼容层、benchmark,做的都是同一件事:把小团队能做出的下限抬高,把上限交给开源生态继续往上推。
等每一块落地,再说更多。